Meta-ExternalAgent : ce que les conditions de Meta du 20 novembre changent pour le site d'une entreprise
À partir du 20 novembre 2026, les conditions commerciales de Meta autorisent le groupe à explorer le site de toute entreprise qui utilise Facebook, Instagram ou WhatsApp à des fins professionnelles. Prévue au 30 octobre, l'échéance a été repoussée par Meta le 23 octobre, après des plaintes d'éditeurs et d'annonceurs. Le mot « entraîner », retiré de la version américaine le 17 octobre, a disparu de la version française entre le 19 et le 26 octobre. La permission d'explorer le site, elle, n'a pas bougé. Aucun refus partiel n'est prévu. Le seul levier que Meta cite est le fichier robots.txt : bloquer Meta-ExternalAgent, son robot d'entraînement, sans toucher aux robots qui affichent les liens partagés, servent la publicité ou citent le site dans Meta AI. Exuno l'a fait le 19 octobre 2026.
Que change la clause du 20 novembre 2026 ?
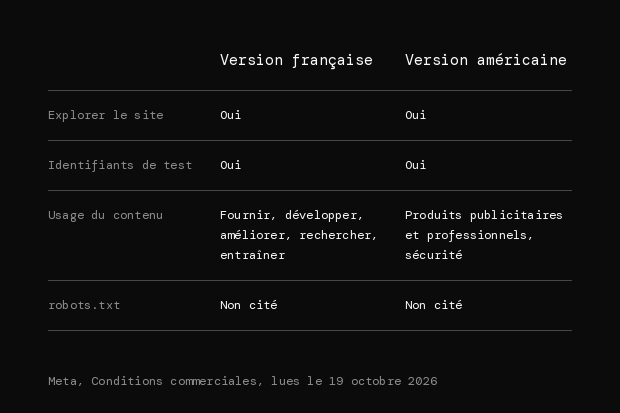
La clause du 20 novembre 2026 ajoute aux conditions commerciales de Meta une permission qui n'y figurait pas : explorer le site d'une entreprise. Dans le texte français, section « Licences et droits que vous fournissez à Meta », l'entreprise autorise Meta, ou toute entité qui agit pour lui, à utiliser des logiciels automatisés (extracteurs de données, bots, robots d'indexation, agents utilisateurs) pour accéder aux domaines et aux pages associés à ses produits ou services. Meta peut les indexer, les analyser et en collecter les mises à jour. Le même paragraphe l'autorise à créer des identifiants de test pour y entrer.
Le texte a changé en 10 jours. Le 15 octobre 2026, la version anglaise citée par Nieman Lab autorisait Meta à utiliser ce contenu pour « fournir, développer, améliorer, rechercher, entraîner » ses produits. Meta a retiré ce mot de la version américaine le 17 octobre, après les critiques de la presse. Le 19 octobre, la version française disait encore « entraîner », comme la version britannique relevée par PPC Land la veille. Le 23 octobre, Meta a repoussé l'entrée en vigueur au 20 novembre. Un porte-parole a dit à Reuters vouloir « davantage de temps pour expliquer à nos partenaires » ce qui change. Le même soir, la phrase sur l'entraînement avait quitté la version britannique, selon PPC Land.
Le 26 octobre 2026, la version française ne contient plus le mot. L'exploration y sert à « fournir, développer, améliorer, rechercher et maintenir des produits publicitaires et commerciaux » et à la sécurité des services de Meta. La permission d'explorer le site reste la même, identifiants de test compris. Le fichier robots.txt n'est toujours cité nulle part.
La version en vigueur jusqu'au 19 novembre ne contient rien de tel. Sa section « Licences » ne porte que sur ce que l'entreprise publie ou importe chez Meta : une photo, une vidéo, le texte d'une Page. Meta présente pourtant la mise à jour comme une « simplification », qui rassemblerait des permissions déjà dispersées dans ses conditions du catalogue produits et ses conditions publicitaires. Pour une entreprise qui vend par un catalogue Meta, les anciennes conditions du catalogue produits contenaient peut-être déjà une partie de cette permission. Les images confiées à l'IA publicitaire de Meta relèvent d'autres conditions, détaillées dans l'article Vidéo publicitaire générée par Meta.
L'accord se donne sans signature. D'après la section « Mises à jour », continuer à utiliser les produits de Meta à des fins professionnelles après la notification vaut acceptation. L'entreprise qui refuse la clause n'a qu'une issue : cesser tout usage professionnel de Facebook, d'Instagram et de WhatsApp.
Quelles entreprises sont concernées ?
Est concernée toute entreprise qui gère une Page ou un groupe, diffuse de la publicité, envoie des messages marketing ou utilise Meta Business Suite, détaille Nieman Lab. Un restaurant qui publie son menu sur son compte Instagram entre dans le champ au même titre qu'une marque qui achète de la publicité chaque mois.
Le texte ne dit pas comment un site devient « associé » aux produits ou services d'une entreprise. Le lien de la Page, la destination d'une publicité, le pixel de mesure ou un catalogue de produits sont des pistes plausibles, que Meta ne confirme pas. Andy Stone, porte-parole de Meta, a expliqué le 16 octobre 2026 à PPC Land que la clause sert à récupérer des informations exactes sur les produits vendus sur des sites tiers, pour les recommandations publicitaires et de contenu. Il a ajouté qu'elle ne vise pas les sites d'information. La version française des conditions ne pose aucune de ces limites.
James Grimmelmann, professeur de droit à l'université Cornell, lisait la version du 15 octobre au sens large dans Nieman Lab : elle autorisait l'entraînement de l'IA sur tout le contenu d'un site. Les identifiants de test, toujours présents, permettraient même de s'inscrire comme un faux utilisateur pour franchir un formulaire d'inscription. Meta a refusé de dire à Nieman Lab si ces identifiants passent les accès payants.
Quels robots Meta envoie-t-il sur un site ?
Meta envoie 5 robots sur les sites, d'après sa documentation pour les développeurs. Le fichier robots.txt les traite un par un : en bloquer un ne bloque pas les autres.
Le robot facebookexternalhit fabrique l'aperçu d'un lien partagé sur Facebook, Instagram ou WhatsApp, avec son titre, sa description et sa vignette. Meta prévient qu'il peut ignorer robots.txt pour des contrôles de sécurité. Le robot meta-externalads sert la publicité et les produits professionnels de Meta. Le robot meta-webindexer alimente la recherche de Meta AI, l'assistant du groupe, pour citer un contenu et renvoyer vers lui. Le robot meta-externalfetcher récupère une page à la demande d'un utilisateur. Il peut lui aussi ignorer robots.txt.
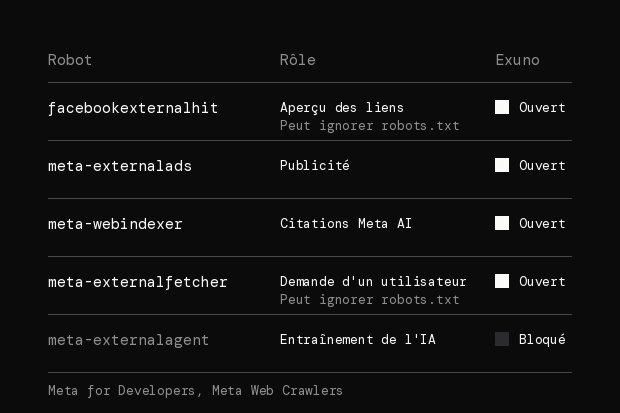
Le 5e robot, Meta-ExternalAgent, est celui de l'entraînement. Meta le décrit comme le robot qui collecte des contenus pour entraîner ses modèles d'IA de fondation ou pour indexer des pages afin d'améliorer ses produits. Sur les journaux de son propre site, en août et en septembre 2026, Olivier Duffez (WebRankInfo) a compté que Meta-ExternalAgent faisait à lui seul 44 % des requêtes, environ 260 000 par jour. Ce relevé porte sur un seul site, spécialisé dans le référencement.
Bloquer Meta-ExternalAgent : ce qu'on garde, ce qu'on perd
Bloquer Meta-ExternalAgent laisse en place ce que les 4 autres robots font pour un site. Les liens partagés gardent leur aperçu, la publicité lit encore les pages de destination, Meta AI peut toujours citer le site grâce à meta-webindexer. Rien dans la documentation de Meta ne relie la portée des publications sur Facebook ou Instagram à ce robot.
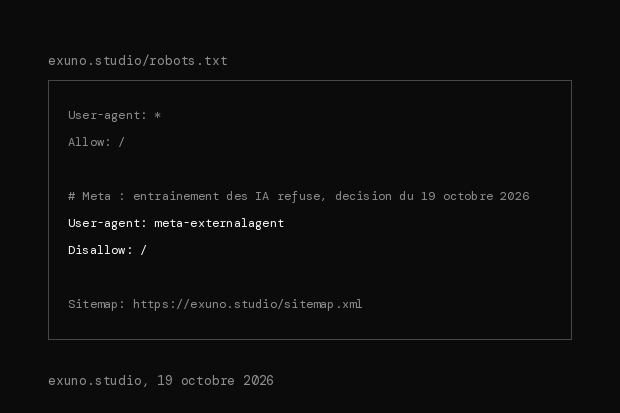
La règle à écrire dans le fichier robots.txt, à la racine du site, est celle que Meta donne lui-même en exemple : « User-agent: meta-externalagent », puis à la ligne suivante « Disallow: / ». Meta garde le fichier en mémoire jusqu'à 24 heures, le blocage prend donc effet dans ce délai.
Ce que le blocage fait perdre se voit moins. D'après Olivier Duffez, un site fermé aux robots d'entraînement reste présent dans les réponses actuelles des IA. Les modèles que Meta entraînera ensuite connaîtront moins bien ce site et la marque qu'il présente. Meta dit aussi que ce robot indexe des pages pour ses produits, sans dire lesquels : un effet sur une fonction secondaire ne peut pas être exclu. L'article Référencement ChatGPT montre comment ce qu'une IA a lu façonne ce qu'elle dit d'une marque.
La CNIL, dans son dossier de juin 2026 sur les robots moissonneurs, invite à régler l'opposition selon ce que fait chaque robot : bloquer un robot de recherche retire le site des sources citées par l'IA. Fermer meta-webindexer ferait perdre les citations dans Meta AI. L'article SEO et GEO explique ce que ces citations pèsent pour un site.
Pour une PME, une agence ou une startup, la décision dépend de ce que le site contient. Un site qui montre des créations, des textes ou une méthode donne à Meta une matière que l'entreprise a fabriquée elle-même. Un site de 4 pages avec une adresse et des horaires lui donne peu.
Le fichier robots.txt suffit-il ?
Le fichier robots.txt ne suffit pas : il formule une demande, que chaque robot choisit de suivre. La CNIL le rappelle dans son dossier de juin 2026 : ces moyens déclaratifs ne sont pas contraignants. Elle cite Cloudflare et Wired, selon qui Perplexity aurait contourné des fichiers robots.txt. Le même dossier relève que 30 millions des 37 millions de domaines explorés par Common Crawl fin 2023 ont un fichier robots.txt, soit environ 81 %.
Meta dit respecter ce fichier. Son porte-parole l'a redit à Nieman Lab, puis à Reuters le 23 octobre : les propriétaires de sites peuvent toujours exprimer leurs préférences par robots.txt. Cet engagement figure dans des courriels à la presse, pas dans le contrat. Le relevé de WebRankInfo montre un écart. Environ 60 % des requêtes de Meta-ExternalAgent visaient des pages que le fichier robots.txt du site interdisait. Olivier Duffez a fini par bloquer le robot au niveau du serveur, qui refuse la connexion au lieu de formuler une demande.
Reste le contrat. Les conditions acceptées par l'entreprise autorisent l'exploration, son fichier robots.txt la refuse. Aucun juge n'a dit lequel des 2 l'emporte. Pour Benjamin Sobel, professeur de droit à l'université du Wisconsin, cité par Nieman Lab, lier les outils professionnels à l'acceptation de l'exploration rappelle la vente liée du droit de la concurrence. L'avocat Matt Topic, interrogé par PPC Land, n'est pas certain qu'un tribunal applique la clause. Il conseille de partir du principe qu'il le fera.
Le droit français donne un rôle au refus exprimé en ligne. L'article L. 122-5-3 du code de la propriété intellectuelle permet à chacun la fouille de textes et de données, sauf si l'auteur s'y est opposé « de manière appropriée, notamment par des procédés lisibles par machine ». Le fichier robots.txt se lit par machine. Qu'il soit « approprié » au sens de la loi, aucune décision ne l'a encore dit. Depuis le 2 août 2025, le règlement européen sur l'IA oblige les fournisseurs de modèles d'IA à usage général à repérer et respecter ces réservations de droits (article 53). La Cour de justice de l'Union européenne doit en préciser la portée (affaire C-250/25, en cours).
Le fichier robots.txt reste le seul refus que Meta documente. Ce refus est daté, visible et lisible par un robot comme par une personne.
Ce qu'Exuno a fait le 19 octobre 2026
Le 19 octobre 2026, j'ai bloqué Meta-ExternalAgent sur exuno.studio. Le fichier robots.txt du site autorisait jusque-là tous les robots. Il garde cette règle générale et ajoute 2 lignes pour le robot d'entraînement de Meta, précédées d'un commentaire qui date la décision. L'ancien fichier est archivé : revenir en arrière consiste à retirer ces 2 lignes.
C'est une prise de position. Ce site montre des créations, des textes et une méthode de travail. Je refuse qu'ils servent à entraîner les modèles de Meta. Le risque est faible, puisque les aperçus de liens, la publicité et les citations dans Meta AI restent ouverts.
Les robots d'entraînement de ChatGPT, de Claude et de Google restent autorisés sur exuno.studio. La clause de Meta est la seule qui porte une date et qui modifie un contrat qu'Exuno accepte en utilisant Instagram. Les autres se décideront à part.
Je préviens avant le 20 novembre les clients dont je gère la publicité Meta. La clause s'appliquera à leurs sites dès qu'ils continueront d'utiliser leurs comptes.
Que vérifier avant le 20 novembre ?
Avant le 20 novembre 2026, 5 vérifications permettent de décider en connaissance de cause.
- Lister les comptes Meta de l'entreprise (Pages, comptes publicitaires, Meta Business Suite) et les sites vers lesquels ils renvoient : chacun peut être un site « associé ».
- Ouvrir le fichier robots.txt actuel, à l'adresse du site suivie de /robots.txt : il dit ce qui est déjà autorisé.
- Choisir robot par robot : bloquer Meta-ExternalAgent pour refuser l'entraînement, laisser facebookexternalhit, meta-externalads et meta-webindexer pour garder les aperçus, la publicité et les citations.
- Garder une copie datée des conditions de Meta et du fichier robots.txt, avant et après le changement.
- Relire les conditions de Meta après le 20 novembre, puis le fichier robots.txt à chaque refonte du site.
Le fichier robots.txt d'exuno.studio tient en 6 lignes, dont 2 pour refuser l'entraînement de Meta.
Les campagnes d'Exuno sont présentées sur la page Campagnes. Ma messagerie est ouverte : WhatsApp.
Sources
Meta, « Conditions commerciales », nouvelle version en aperçu, section « Licences et droits que vous fournissez à Meta », versions française et américaine lues le 19 octobre 2026, version française relue le 26 octobre 2026 : https://www.facebook.com/legal/commercial_terms_preview
Meta, « Conditions commerciales », version en vigueur jusqu'au 19 novembre 2026, lue le 19 octobre 2026 : https://www.facebook.com/legal/commercial_terms
Meta for Business, « Simplification des Conditions commerciales, des Conditions générales du catalogue produits, des Conditions d'utilisation des publicités en libre-service et des Conditions générales de l'IA générative pour les contenus publicitaires de Meta », lue le 19 octobre 2026 : https://www.facebook.com/business/help/2481113349080785
Meta for Developers, « Meta Web Crawlers », lue le 19 octobre 2026 : https://developers.facebook.com/docs/sharing/webmasters/web-crawlers
Andrew Deck, « Meta's new commercial terms will allow the scraping of news sites, legal experts say », Nieman Lab, 15 octobre 2026 : https://www.niemanlab.org/2026/10/metas-new-commercial-terms-will-allow-the-scraping-of-news-sites-legal-experts-say/
Luis Rijo, « Meta grants itself the right to crawl advertisers' websites for AI », PPC Land, 17 octobre 2026 : https://ppc.land/meta-grants-itself-the-right-to-crawl-advertisers-websites-for-ai/
Luis Rijo, « Meta's AI training clause still in Oct 30 terms after report of removal », PPC Land, 18 octobre 2026 : https://ppc.land/metas-ai-training-clause-still-in-oct-30-terms-after-report-of-removal/
Luis Rijo, « Meta delays website-crawling terms to Nov 20 after publisher complaints », PPC Land, 23 octobre 2026 : https://ppc.land/meta-delays-website-crawling-terms-to-nov-20-after-publisher-complaints/
FashionNetwork avec Reuters, « Meta reporte ses nouvelles conditions commerciales critiquées par les annonceurs », 23 octobre 2026 : https://fr.fashionnetwork.com/news/Meta-reporte-ses-nouvelles-conditions-commerciales-critiquees-par-les-annonceurs,1878802.html
Romain Darous, « S'opposer à la collecte de données par des robots moissonneurs », CNIL, LINC, juin 2026 : https://linc.cnil.fr/sites/default/files/2026-06/linc_s_opposer_a_la_collecte_de_donnees_par_des_robots_moissonneurs_dossier_juin_2026.pdf
CNIL, « La base légale de l'intérêt légitime : fiche focus sur les mesures à prendre en cas de collecte des données par moissonnage (web scraping) », 19 juin 2025 : https://www.cnil.fr/fr/focus-interet-legitime-collecte-par-moissonnage
Olivier Duffez, « Liste des crawlers des moteurs IA en 2026 », WebRankInfo, journaux d'août et septembre 2026, lue le 19 octobre 2026 : https://www.webrankinfo.com/dossiers/ia/crawlers
Code de la propriété intellectuelle, article L. 122-5-3, Légifrance : https://www.legifrance.gouv.fr/codes/section_lc/LEGITEXT000006069414/LEGISCTA000006161637/
Règlement (UE) 2024/1689 du 13 juin 2024 sur l'intelligence artificielle, articles 53 et 113, EUR-Lex : https://eur-lex.europa.eu/legal-content/FR/TXT/HTML/?uri=CELEX:32024R1689